
 Đội ngũ DevPixel
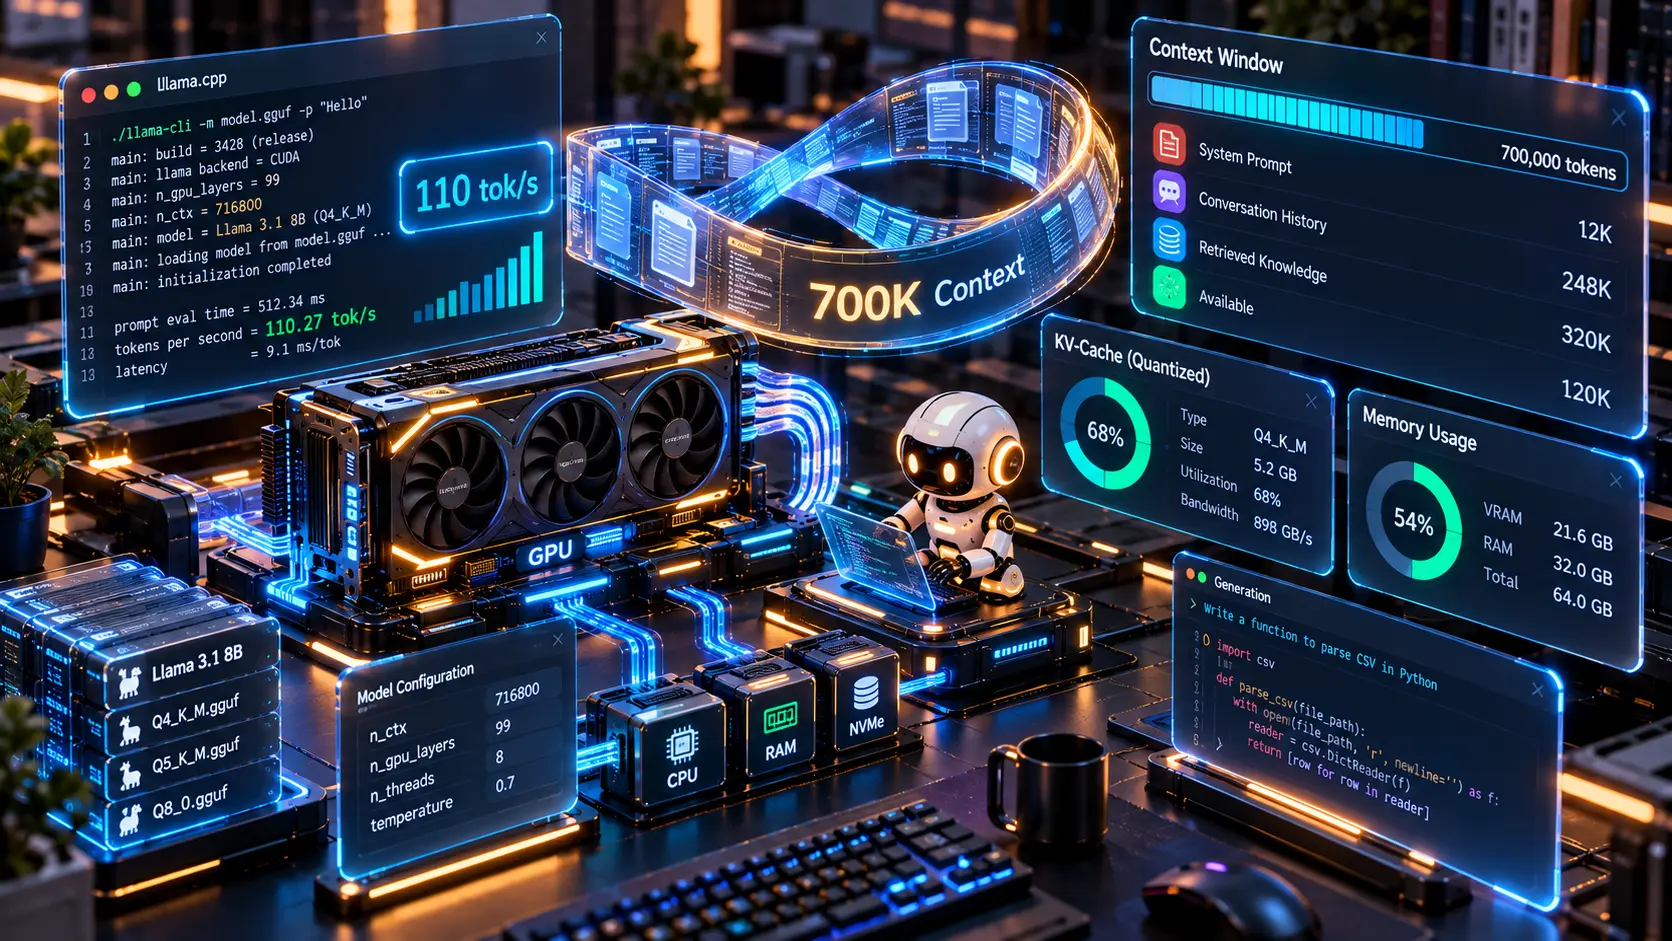
Trong kỷ nguyên mà các mô hình ngôn ngữ lớn hỗ trợ cửa sổ ngữ cảnh lên tới hàng trăm nghìn hoặc hàng triệu token, thách thức lớn nhất đối với các kỹ sư chạy mô hình cục bộ (Local LLM) không còn là dung lượng tham số, mà là tốc độ suy luận và mức tiêu thụ VRAM của bộ nhớ đệm KV Cache. Khi ngữ cảnh vượt quá 100K token, các kỹ thuật chú ý truyền thống (Attention) sẽ làm cạn kiệt bộ nhớ đồ họa và khiến tốc độ sinh từ rơi xuống mức vài token mỗi giây.
Các báo cáo kỹ thuật gần đây từ cộng đồng nghiên cứu AI mã nguồn mở cho thấy việc chạy thành công các mô hình như Qwen 3.8 Flash với cửa sổ ngữ cảnh 700K token liên tục không cần nén phiên (session compaction) trên phần cứng máy trạm tiêu chuẩn. Đằng sau bước đột phá này là sự kết hợp của 3 kỹ thuật cốt lõi: FlashAttention thế hệ mới, Sliding Window Attention (SWA) và bộ đệm thông minh SmartCache.
Chi phí bộ nhớ của KV Cache tăng tuyến tính theo độ dài ngữ cảnh và kích thước batch. Ở 700K token, nếu dùng định dạng FP16 tiêu chuẩn, riêng KV Cache có thể ngốn hơn 40GB VRAM — vượt quá khả năng của hầu hết GPU tiêu dùng nếu không áp dụng lượng tử hóa KV Cache và định tuyến thông minh.
1. Tam Giác Kỹ Thuật Tối Ưu Cửa Sổ Ngữ Cảnh Khổng Lồ
Để duy trì tốc độ sinh từ trên 100 token/giây ở độ dài ngữ cảnh 700K token, hệ thống cần phối hợp đồng bộ:
- Lượng tử hóa KV Cache (KV Cache Quantization): Chuyển đổi bộ nhớ đệm Key-Value từ định dạng FP16 sang INT8 hoặc INT4 (như k-quants trong llama.cpp). Bước này cắt giảm tới 75% dung lượng VRAM mà suy hao độ chính xác gần như không đáng kể.
- Sliding Window Attention (SWA): Không phải mọi token trong quá khứ đều cần chú ý toàn diện ở mọi tầng mạng. Việc áp dụng cửa sổ trượt cục bộ kết hợp với một vài token neo cố định (Attention Sinks) giúp giữ cho ma trận chú ý luôn nằm trong ngưỡng tính toán tối ưu.
- SmartCache & Tái Sử Dụng Prompt (Prompt Caching): Lưu lại trạng thái KV Cache của toàn bộ mã nguồn dự án vào RAM hệ thống, chỉ tải vào VRAM những phần ngữ cảnh thay đổi trong lượt trao đổi hiện tại.
2. Cấu Hình Thực Tế Với llama.cpp Và vLLM
Khi triển khai mô hình cục bộ phục vụ làm việc với các kho mã nguồn khổng lồ, các kỹ sư cần tinh chỉnh các cờ tham số quan trọng:
Đọc thêm: Quy Trình Tự Động Hóa Code Review Khi AI Viết Hơn 90% Mã Nguồn
Lời Kết
Khai thác cửa sổ ngữ cảnh cực lớn trên môi trường cục bộ giúp kỹ sư xóa bỏ rào cản phụ thuộc vào API đám mây, bảo toàn 100% dữ liệu mã nguồn nội bộ và biến máy trạm thành một trung tâm phân tích phần mềm thông minh có sức mạnh tương đương các cụm máy chủ lớn.
Chưa có bình luận nào. Hãy là người đầu tiên chia sẻ góc nhìn!