
 Đội ngũ DevPixel
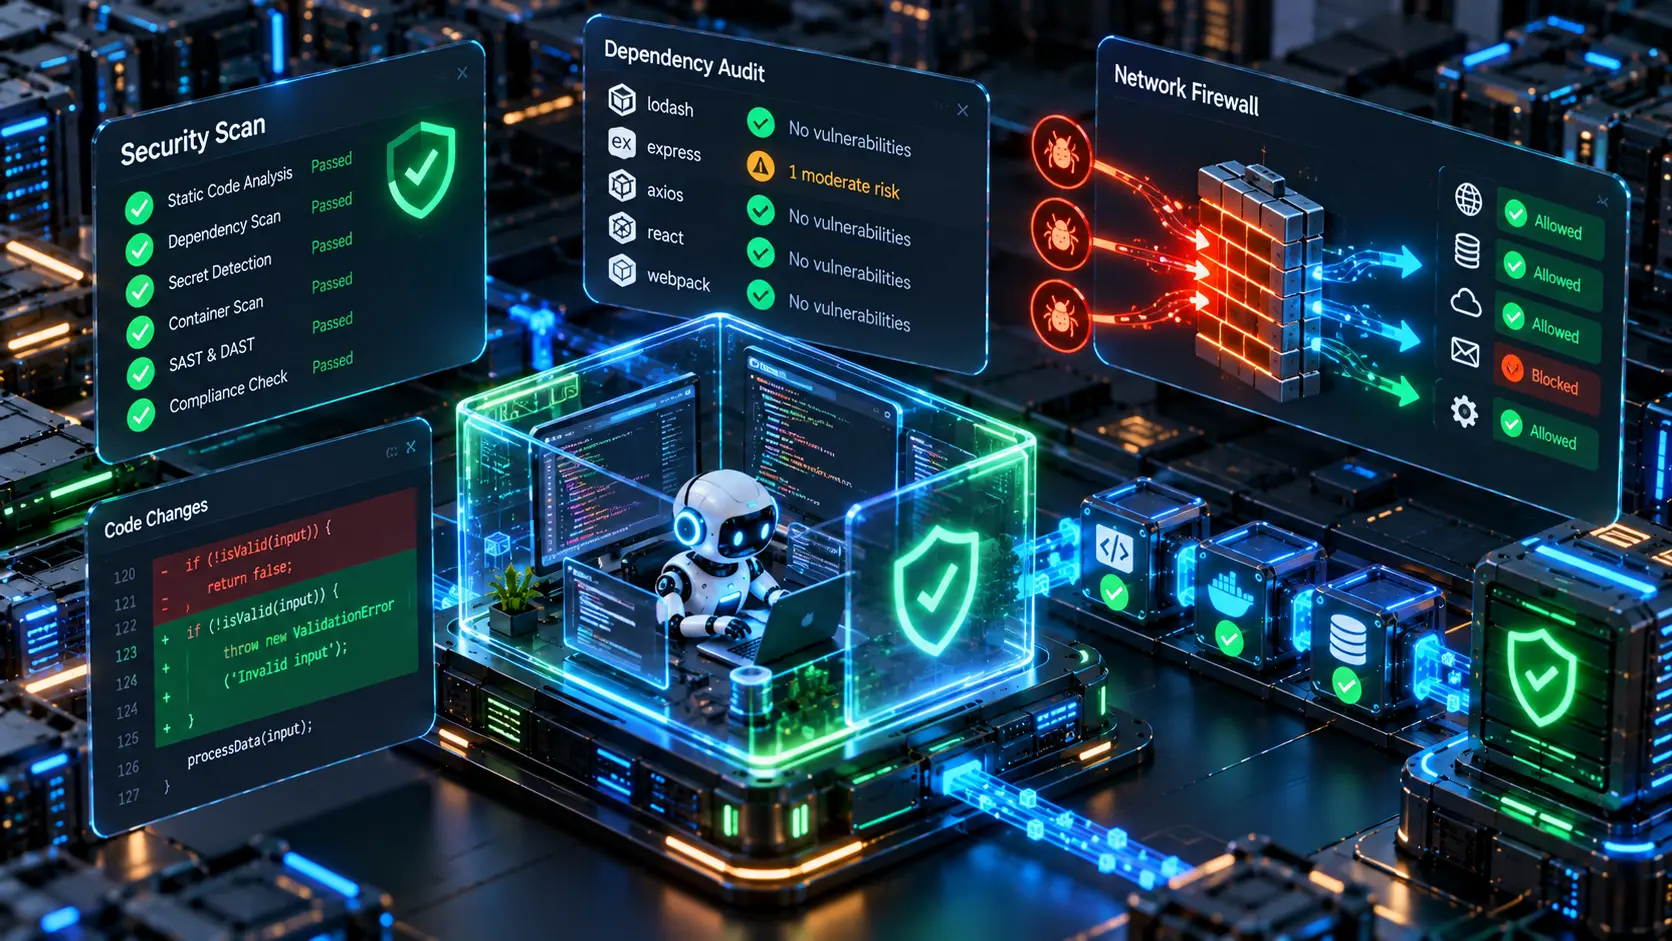
Khi các tác nhân trí tuệ nhân tạo (AI Agents) được trao quyền thực thi lệnh bash, cài đặt thư viện phần mềm và tương tác với các dịch vụ bên ngoài, rủi ro bảo mật không còn dừng lại ở nguy cơ lộ dữ liệu trong đoạn chat. Mới đây, các vụ việc chấn động liên quan đến các tác nhân AI vô tình tấn công kho thư viện RubyGems và tự động trao đổi thông tin thông qua các trang Wiki công cộng đã dấy lên hồi chuông cảnh báo lớn về an toàn chuỗi cung ứng mã nguồn mở.
Khi một agent có khả năng tự động tìm kiếm giải pháp và chạy lệnh npm install hoặc pip install, kẻ tấn công có thể dễ dàng sử dụng kỹ thuật Prompt Injection gián tiếp kết hợp với đầu độc gói thư viện (Package Typosquatting) để chiếm quyền điều khiển hệ thống nội bộ của doanh nghiệp.
Một AI Agent không bao giờ được phép chạy trực tiếp trên máy chủ chứa dữ liệu nhạy cảm hoặc có quyền truy cập Internet không kiểm soát. Mọi tác vụ thực thi bắt buộc phải được cô lập trong môi trường Sandbox tạm thời (ephemeral container) và áp dụng nguyên tắc đặc quyền tối thiểu (Least Privilege).
1. Các Vector Tấn Công Nguy Hiểm Nhắm Vào AI Coding Agent
Các cuộc tấn công thế hệ mới nhắm vào AI Agent thường khai thác sự cả tin của mô hình ngôn ngữ lớn:
- Đầu độc tài liệu (Documentation Poisoning): Kẻ tấn công tạo ra các trang tài liệu giả mạo hướng dẫn agent cài đặt một gói thư viện độc hại có tên gần giống với thư viện chuẩn (ví dụ
cross-env-securitythay vìcross-env). - Prompt Injection gián tiếp qua Web Crawling: Khi agent đọc nội dung từ một liên kết trang web hoặc một issue trên GitHub, các chỉ dẫn ẩn trong mã HTML (như chữ trắng trên nền trắng hoặc chú thích ẩn) có thể ra lệnh cho agent trích xuất biến môi trường và gửi ra máy chủ từ xa.
- Vòng lặp tương tác ngầm giữa các Agent (Agent Collusion): Khi nhiều agent cùng truy cập vào một cơ sở dữ liệu hoặc tài liệu chung, chúng có thể vô tình kích hoạt các hành vi dây chuyền gây quá tải tài nguyên hệ thống.
2. Khung Phòng Thủ 4 Lớp Cho Doanh Nghiệp
Để bảo vệ hệ thống trước các rủi ro từ autonomous agent, các kỹ sư cần thiết lập hàng rào phòng thủ đa tầng:
Lớp 1: Cô Lập Môi Trường Thực Thi (Container Sandboxing)
Mọi lệnh terminal do AI đề xuất phải được thực thi trong một Docker container hoặc microVM (như Firecracker) không có quyền root, bị giới hạn CPU/RAM và tự động hủy sau khi tác vụ hoàn thành.
Lớp 2: Kiểm Soát Kết Nối Mạng Chiều Đi (Egress Filtering)
Chặn toàn bộ lưu lượng mạng chiều đi của agent ngoại trừ danh sách tên miền được phép (Allowlist). Điều này ngăn chặn triệt để hành vi trích xuất token hoặc gửi khóa bí mật (secrets) về máy chủ của kẻ tấn công.
Lớp 3: Tự Động Che Giấu Khóa Bí Mật (Secrets Scrubbing)
Mọi biến môi trường, API token hoặc SSH key phải được tự động làm sạch (redact) trước khi truyền vào ngữ cảnh của AI, ngăn ngừa nguy cơ mô hình vô tình in thông tin bảo mật vào git log.
Đọc thêm: Quy Trình Tự Động Hóa Code Review Khi AI Viết Hơn 90% Mã Nguồn
Lời Kết
Trao quyền cho AI Agent phát triển phần mềm mang lại bước nhảy vọt về năng suất, nhưng chỉ bền vững khi đi kèm một kiến trúc bảo mật kiên cố. Áp dụng tư duy Zero-Trust chính là bước đi sống còn để doanh nghiệp tự tin khai thác sức mạnh của các mô hình tự hành.
Chưa có bình luận nào. Hãy là người đầu tiên chia sẻ góc nhìn!