
 Đội ngũ DevPixel
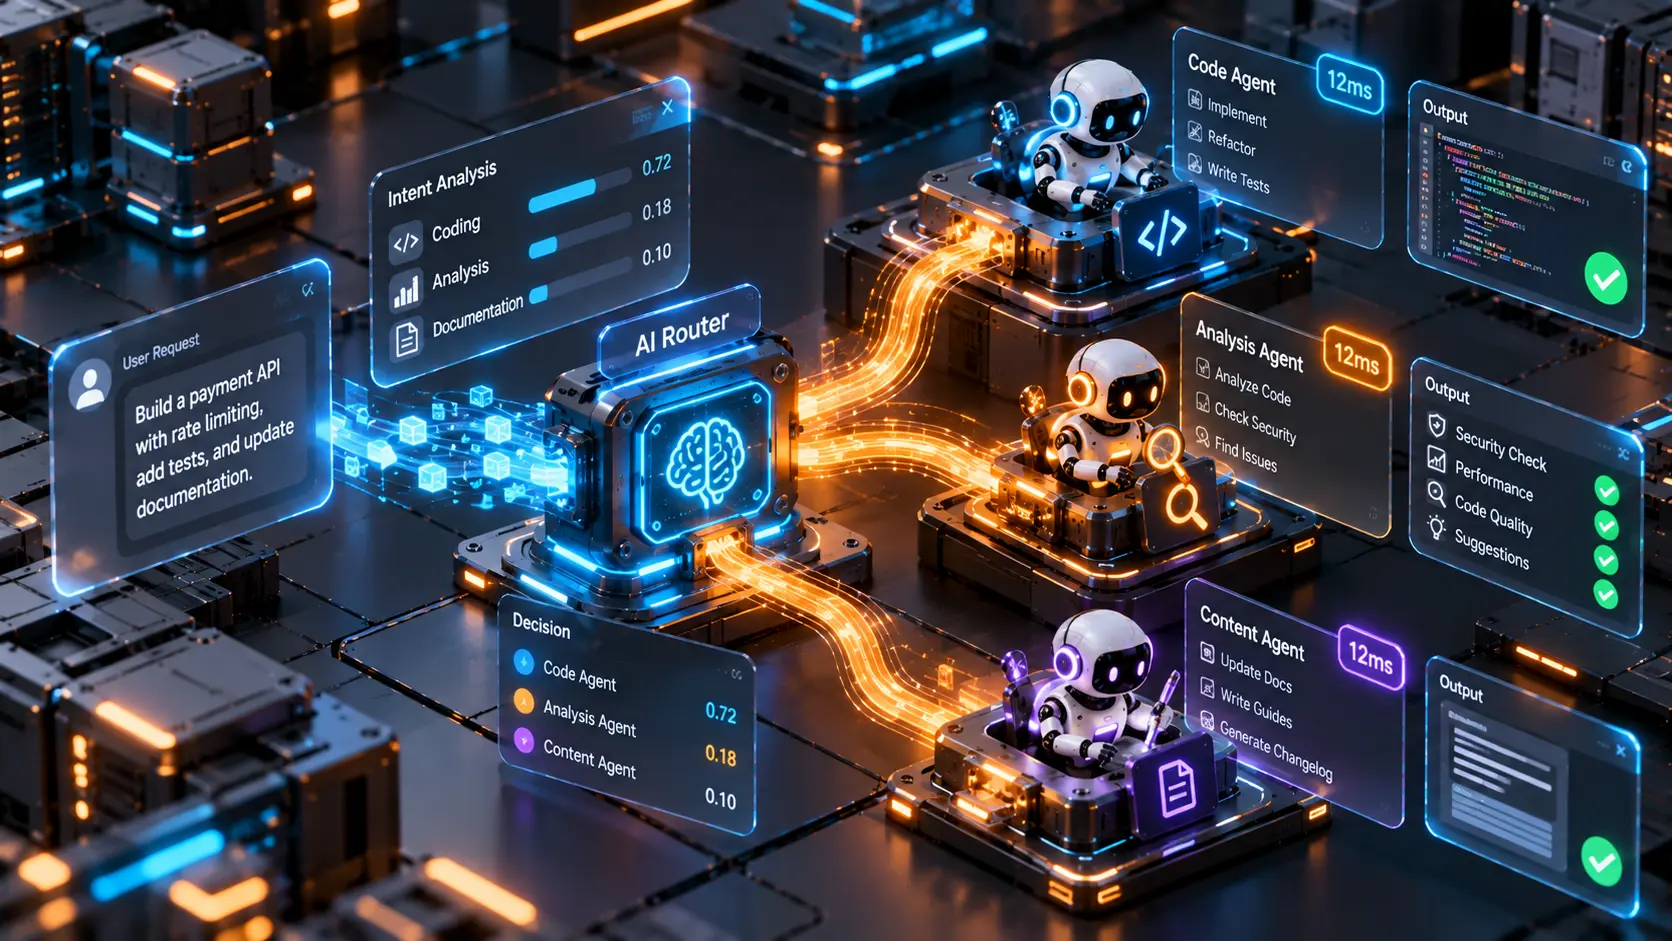
Trong các kiến trúc hệ thống Multi-Agent hiện đại, một trong những thách thức lớn nhất làm giảm trải nghiệm người dùng và tăng chi phí vận hành là độ trễ định tuyến (routing latency). Khi người dùng gửi một yêu cầu, hệ thống thường phải gọi một mô hình ngôn ngữ lớn (LLM) để sinh văn bản giải thích, phân tích ngữ cảnh rồi mới quyết định chuyển tác vụ sang agent chuyên môn nào.
Sự ra đời của Mô hình System One (hay còn gọi là Decision Models — Mô hình Quyết Định) đang thay đổi hoàn toàn cục diện này. Thay vì tạo ra văn bản tự nhiên, các mô hình này được huấn luyện đặc thù để xuất trực tiếp các vector số thực, phân loại nhị phân và điểm số tự tin (confidence scores) trong thời gian tính bằng mili-giây.
Lấy cảm hứng từ tâm lý học hành vi của Daniel Kahneman, System 1 đại diện cho phản xạ tức thì, trực giác và phân loại siêu tốc; trong khi System 2 là tư duy suy luận sâu (Reasoning). Sử dụng System 2 cho các tác vụ phân luồng đơn giản là sự lãng phí tài nguyên khổng lồ.
1. Điểm Khác Biệt Giữa Generative LLM Và Decision Model
Các mô hình sinh văn bản truyền thống (Generative LLMs) được tối ưu hóa cho tác vụ tự hồi quy (autoregressive token generation). Khi dùng làm bộ định tuyến (Router):
- Mô hình phải sinh chuỗi văn bản (ví dụ:
{"target": "billing_agent", "confidence": 0.95}). Quá trình này tiêu tốn từ 200ms đến 1.500ms cho bước định tuyến đầu tiên (Time-to-First-Token). - Đòi hỏi parser JSON để bóc tách kết quả, dễ gặp lỗi cú pháp nếu mô hình sinh thêm từ ngữ phụ.
- Decision Models: Nhận văn bản đầu vào nhưng tầng xuất (Output Head) là các bộ phân loại tuyến tính xuất ra mảng xác suất số thực. Thời gian phản hồi chỉ từ 5ms đến 25ms với chi phí tính toán thấp hơn 90%.
2. Ứng Dụng Thực Chiến Trong Hệ Thống Multi-Agent
Trong kiến trúc điều phối tác nhân (tương tự như mô hình trong bài viết Pipeline 4 Agent trong Claude Code), Decision Models đảm nhiệm các chốt chặn quan trọng:
- Phân luồng Intent tốc độ cao: Phân biệt tức thì giữa câu hỏi tra cứu thông tin (RAG), yêu cầu thực thi mã nguồn (Coding Agent), hay tác vụ quản trị tài khoản để chuyển thẳng sang worker phù hợp.
- Kiểm duyệt an toàn (Guardrails & Jailbreak Detection): Đánh giá mức độ rủi ro của câu lệnh đầu vào với độ trễ gần như bằng 0 trước khi chuyển tiếp vào các mô hình đắt tiền.
- Đánh giá chất lượng đầu ra (Reward Modeling): Chấm điểm độ tin cậy của các câu trả lời do các agent thành viên sinh ra để chọn giải pháp tối ưu nhất.
Đọc thêm: Hướng Dẫn Tích Hợp gstack Vào Claude Code
Lời Kết
Sự kết hợp hài hòa giữa Decision Models (System 1) để điều hướng siêu tốc và Reasoning Models (System 2) để xử lý logic phức tạp chính là chìa khóa kiến trúc giúp các hệ thống AI quy mô lớn đạt được sự cân bằng hoàn hảo giữa hiệu năng, độ trễ và chi phí.
Chưa có bình luận nào. Hãy là người đầu tiên chia sẻ góc nhìn!